熟悉,但又没那么熟悉 … 仅记了一些比较熟悉的部分,这一章最后两节 Database and Streams 和 Processing Streams 看的有点蒙。
定义
批量处理(Batch Processing)每次处理的数据都是全量的,也就是说,如果这批全量数据中只有部分数据有变更,想让其生效,也需要再跑一遍全量的数据,这就导致了批量处理的时效性不高。如果对数据的时效性有要求,那么就可以采用流式处理(Stream Processing)的模式,这种模式下,每次处理的不是全量的数据,而是单个/极少的,一条数据被称为一个 event/message 。并且和批量处理不同,流式处理的场景下,对于整体的数据处理,一般是没有开始和结束的概念的,就类似于是处理一个 unbounded 的数据流。
在根据日志筛选发送请求量高的 ip 的场景中,命令 cat *.log.* | awk '...' | sort | uniq -c | sort -n | head -10 里,对于 awk / sort / uniq 来说,它们处理的就类似于是流式的数据。从它们的视角看,每次从 stdin 中按行读取一条条的 event(数据),在进行处理后,也是按照行粒度向 stdout 中产出处理完成的数据,一直到 stdin 中读到 EOF ,意味着输入流终止了。
几个关键点
在命令行场景中,通过 Unix 管道串起了各个进程来完成流式处理,管道会将上游进程写入到 stdout 中的数据缓存在内存中,并写入到下游进程的 stdin 中。如果上游进程产出数据的速度大于下游进程消费数据的速度,缓冲区写满了,那么上游进程写入 stdout 的流程会被阻塞,类似于是反压的效果。如果下游的进程挂了,对应的 stdin fd 被销毁,那么整体流式处理的流程就会被终止,在管道缓冲区中未被处理的数据会丢失。如果消费者正常消费数据,不论最后是否处理成功,相应的数据被消费完后就被删除了,不会被额外保存。上面描述的场景中有几个关键点,可以简单概括为:1)上游生产者(producer)产出数据速度大于下游消费者(consumer)是应该如何处理。2)消费者下线时生产者应该怎么做。3)生产者产出的数据的生命周期是怎样的
在一些比较简单的场景下,producer 和 consumer 直接通过 RPC 来进行通信,这种方式和 Unix 管道类似,当 consumer 消费能力不足,或者下线时,producer 侧要么有反压机制,不继续下发数据,要么就直接将数据丢弃。对于下发给 consumer 的数据,除非在 producer 端或者 consumer 端新增额外的机制,否则相关数据也不会被存储。
另一种方式是引入消息队列,producer 将数据写到消息队列中,consumer 从 broker 拉取数据 。在这种模式下,如果 consumer 的消费能力不足,或者下线时,未被处理的消息会保留在消息队列中。对于写入到消息队列中的数据的生命周期,由消息队列来进行控制。可以看到,消息队列对于数据的操作包括了写入/读取/数据存储,这正好也是一般数据库做的事情,但由于一般数据库没有针对”读取最新未被处理消息(deliver event notification)“这一场景做特殊优化,所以不适合直接作为消息队列。
基于 log 的消息队列
数据存储
在 AMQP/JMS 风格的消息队列实现中,当消费者消费了生产者产出的数据后,这个数据就被删除,也即数据的生命周期为,从生产者写入数据开始,到消费者成功完成消费,这种模式是无法重复消费历史的数据。当生产者将数据写入消息队列时,下游多个消费者并行从队列中拉取数据,这可能会有乱序的问题,比如说 v1 和 v2 依次写入队列中,但是下游消费 v1 超时,在 v2 被处理后,v1 被另一个消费者重新消费,最终的结果是 v2 比 v1 先被处理。
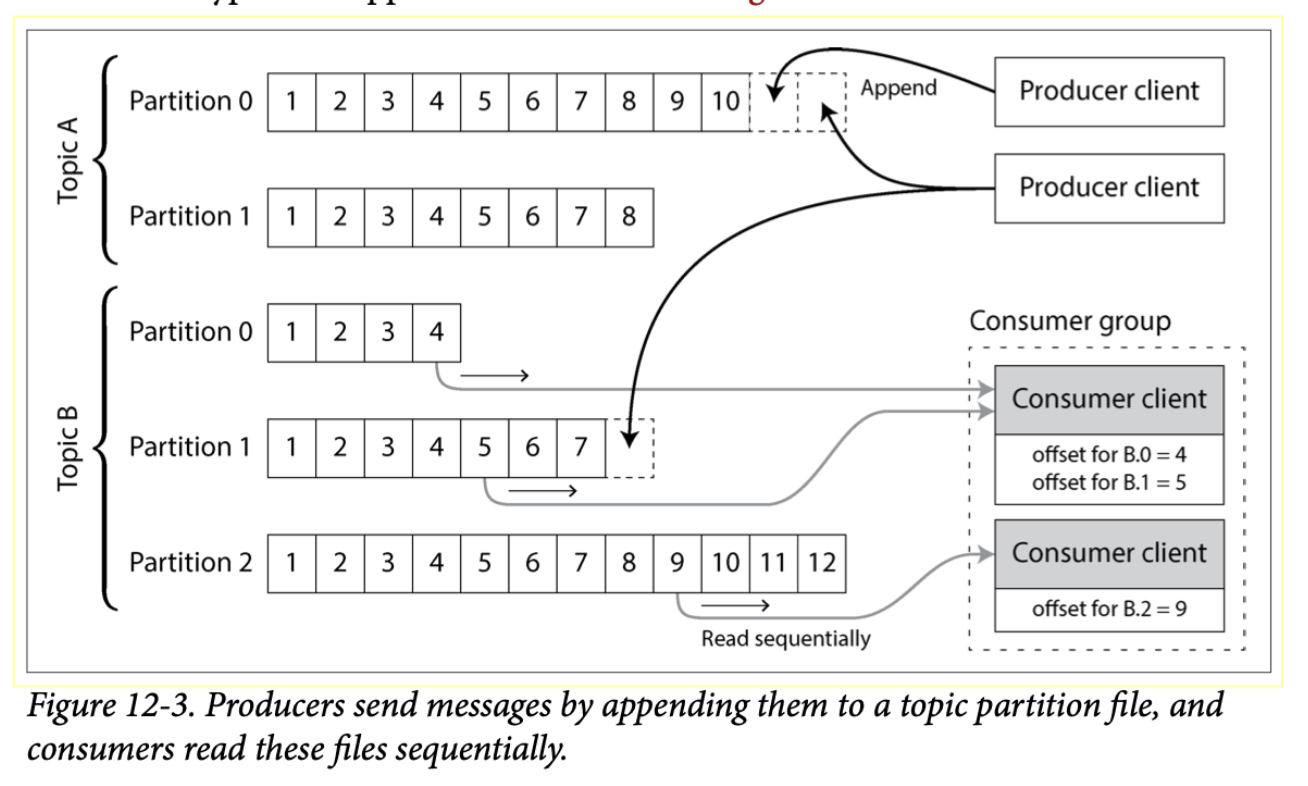
另一种是基于 log 的消息队列,例如 Kafka 。一条 Stream 下的所有数据都被写到一个 topic 中,一个 topic 分为了多个分片,如果指定了数据的 key, 则会根据 key 进行 hash 写到指定的分片上,否则是随机写入一个分片。每一个分片上的数据是按照类似于 log 的形式进行组织的,新的数据追加写到 log 结尾,并给分配了一个 offset 作为 id 。在消费数据时,也是从这个 log 上按需进行消费的。
数据过期
写入到 log 中的数据有两种自动过期方式,但是都和外部的消费者和生产者无关。一种为设置过期时间,这种模式下,消息队列根据数据的写入时间对历史数据进行删除,另一种为设置 compact ,对于相同的 key ,消息队列对定期删除除最新 key 对应的数据之外的其它历史数据。
对于 Kafka,有一点比较有意思的是,也有可能出现数据按照时间预期过期了但是依然可以读到的情况,这种情况经常是在希望直接设置过期时间为 0 以清空历史的场景中出现的。在存储一个 log ,也即一个分片,的数据时,Kafka 将 log 切分为了多个 segment ,此时假如最新的 segment 有正在被消费者读取,即使这个 segment 上包含了预期过期的数据,这部分数据也是不会被删除的。所以一般清空历史数据使用的是 Kafka 的一个脚本 kafka-delete-records.sh ,通过设置 low watermark 将数据置为不可读来实现的。
这里之所以将 log 切分为了多个 segment 来存储,其中之一的目的也是为了方便。在对 log 进行过期的时候,是按照 segment 粒度来进行过期的,将整个文件标记为删除比删除单个文件的部分内容成本低的多,前者直接 unlink 即可,后者会消耗读写的 io 。
保序
在建库场景下,一个典型的场景为,如果同一个 url 的数据下发了多次,那么在消费者消费时需要按照下发的顺序来进行处理。在 Kafka 的场景中,在写入数据时,将 url 作为 Kafka 消息的 key ,这样可以保证都被写入到了一个分片中。Kafka 的消费者在消费一个分片的数据时,要求使用单线程进行处理,这样就可以保证一个分片中的数据严格按照写入的数据被处理。
消费者组
对于一个 topic 的数据,常常需要多个服务来读取,而一个服务,也可能会消费多个 topic 的数据。Kafka 引入了消费者组(Consumer Group)的概念,同一个消费者组中的消费者消费一批 topic 的数据,不同消费者组互不干扰。一个消费者组中,会记录各个 topic 中相应分片的消费 offset ,这个是由消费者提交的。在 c++ 的实现中,一般是在 Kafka Message 定义的 class 中的析构函数里定义提交 offset 的逻辑,这样假如它外部包着智能指针的话,在业务逻辑处理完毕后,会内存释放自动提交 offset 。可以编写 exporter ,采集一个消费者组中分片最新的 offset 及消费者提交的 offset 来计算并获取消费的 lag 信息。
上一节提到,对于一个分片的消费,是需要单线程进行的,那么在将数据从 Kafka 中读出来后,在处理数据阶段,是否可以多线程进行呢?对于上面提到的 c++ 实现来说,是不行的,除非可以容忍丢数据。因为假如数据 [a, b, c]被多线程处理,那么如果数据 c 先被处理完毕,那么此时自动提交的 offset 为 c 的,这个 offset 大于 a 和 b 。如果 a 和 b 未被处理完成,且消费者挂了,那么新的消费者会接着处理 c 之后的数据,a 和 b 的数据就丢失了。
这种消费模式的一个坏处为,假如分片的某个消息处理很慢甚至卡主了一直不成功,则会阻塞这个分片后续所有数据的处理。更严重的情况是,假如数据会导致消费者异常,比如 coredump ,那么就会出现消费者A coredump 挂了,然后将这个分片分配给消费者B ,然后 B 也挂了,接着分配给 C … 最终导致整个系统状态异常。这种情况的处理方式,一种是最好异常的捕获,然后将问题数据写死信队列(DLQ),另一种临时补救的方式是使用 Kafka 的脚本 kafka-consumer-groups.sh 强制提交这个 offset ,假装这个数据已经被处理了,以达到跳过问题数据的效果。
还有一点需要注意的是,对于一个消费者组,其中的消费者的数量最多为消费的 topic 的分片数之和,因为一个分片只能被一个消费者消费。假如消费者整体的消费能力不足,那么在不扩分片的情况下,无法通过再新增消费者来加速消费。
一些好处
由于数据存储在了消息队列中,所以当下游的消费者处理数据有异常时,可以将输入数据读出来确认输入数据内容,并且可以在线下启服务消费数据来进行复现,在完成修复后,通过重置消费的 offset 来回溯订阅点,重新消费历史数据。
当消费者处理数据的能力不足时,数据是被存储在消息队列中的,不用担心丢失。离线建库的不少服务,对外提供了 RPC 的接入方式,不过在收到 RPC 消息后,在执行了一些较轻的逻辑,例如鉴权后,会将数据直接写到 Kafka 中,再由额外的线程进行订阅和进行重逻辑计算。通过这种方式,可以减少外部业务推数据把服务的风险。不过由于这种方式算是异步处理,数据的推送方无法感知到数据最终处理的结果。
同步接口改异步
使用消息队列的一个目标,就是进行削峰,也即在上游生产者流量暴涨或者下游消费者处理能力不足时,如何保证消费者不被打挂,且需要处理的数据不丢。一种方式就是改一下消费者的同步 RPC 接口,在收到数据后随即写消息队列,然后由额外的线程作为消费者消费消息队列中的数据。
上述的修改方案是对消费者进行改造,在工作中我还见过另外一种写法,目标是不改消费者。首先是由生产者写消息队列,然后在消息队列的下游接一个额外的中间消费者,由这个中间消费者从消息队列中读数据然后请求下游的同步 RPC 接口。在这种模式下,可以人工/自动调整这个消费者下发下游的速率做流控。
其它
数据库中有一些地方,和基于 log 模式的流式处理有一些相似的地方。比如说对于数据的操作,它都会先写到 log 当中,然后基于 log 来对实际数据的存储结构进行修改。在多副本的场景下,在从节点同步数据时,也是先以一个快照作为 base ,然后同步之后的 log 。从这种处理模式看,实际上消息队列可以从一定程度上模式数据库,也是使用 compact 的模式,这样数据写入后,除非人为删除,就可以永久保存在 log 当中了。只不过在进行数据查询时,只能基于 offset 和时间戳来 seek 数据。
书中提到了一个机制 change data capture(CDC),用于感知数据库中所有的数据变化,并将其转发至其它系统中。像是 Kafka 之类的消息队列都提供了相应的支持框架,支持将相关数据导致至消息队列中,并从其中进行读取,例如 Kafka Connect 。23 年做 MongoDB 表迁移时,使用的 MongoShake 实现的应该就是类似的机制,它是先同步一份 base 的表数据至目标集群,然后再订阅 MongoDB 的 log 来做增量同步,同步时就直接将变更写 Kafka 之类的消息队列。
在计算流式处理的延时时,由于是异步处理,所以统计分为了几个阶段,首先是生产者写消息队列的时间,然后是数据在消息队列中等待被消费的时间,最后是数据被消费者处理的时间。目前的线上系统中,一般都是统计最后一段时间。但是如果需要统计全部的时间,书中提到有几点需要考虑,一个是生产者写入消息使用的时间戳和最后消费者消费时间的时间戳,这两使用的时间是否有问题,比如使用的时间不准,导致最终减出来的时间是负的,另外就是如果有回溯消息,那么就会导致消费者消费到一个较早的数据,最终导致算出来的延时特别高。
上面提到过,基于 log 的消息队列的有个优势为,支持对历史消息进行回溯,但此时需要考虑的问题就是消费者处理消息的逻辑是否是幂等的,也即如果一条数据被处理了多次,是否跟处理一次的效果是一样的。如果不是幂等的话,对于历史消息的回溯需要慎重操作。