国庆期间争取手写一个 raft 出来!
引言
为了提升系统的可用性,一般都会引入多副本机制,也即 replication 。此时同一份数据被存在了不同的副本上,而这些副本分散在不同的机器上,就会有一致性(consistency)的问题,也即同一份数据的不同副本,它们的值可能是不一致的。一个典型的场景为,假如一个数据是三副本 a、b、c ,在数据写入至副本 a 后,b 和 c 同步存在延时,那么此时随机选取副本进行数据读取,如果目标副本的数据同步完毕了,那么读到的是新的数据,否则读到的就是老数据,如果发起多次读取,可能一会读到新数据一会读到老数据,此时可以认为这个数据是不一致的。
Linearizability
如果一个系统对外承诺它维护的数据是一致性的,那么对于系统的使用者来说,即使实际是多副本的情况,在读写的时候体感也需要跟单副本一样,比如说当数据完成写入后,说从某一个时间点后,可以稳定读到最新的数据。这种一致性被称为 Strong Consistency ,又可以被称为 Linearizability 。我们可以将这个系统中发生的所有操作根据时间落到一个线性的时间轴上,各个操作之间有明确的先后顺序。Linearizability 和 Serializability 是有区别的,前者是将所有的操作序列化为一个线性的顺序,要求前一个写发生后后一个读必须可以读到,不保证顺序对于业务的合理,所以这并不解决 write skew 等问题。因为实际的操作的发生还是会交叉进行。后者是将一系列的 transcation 序列化为一个线性的顺序执行,有些操作和实际的先后顺序不一样。
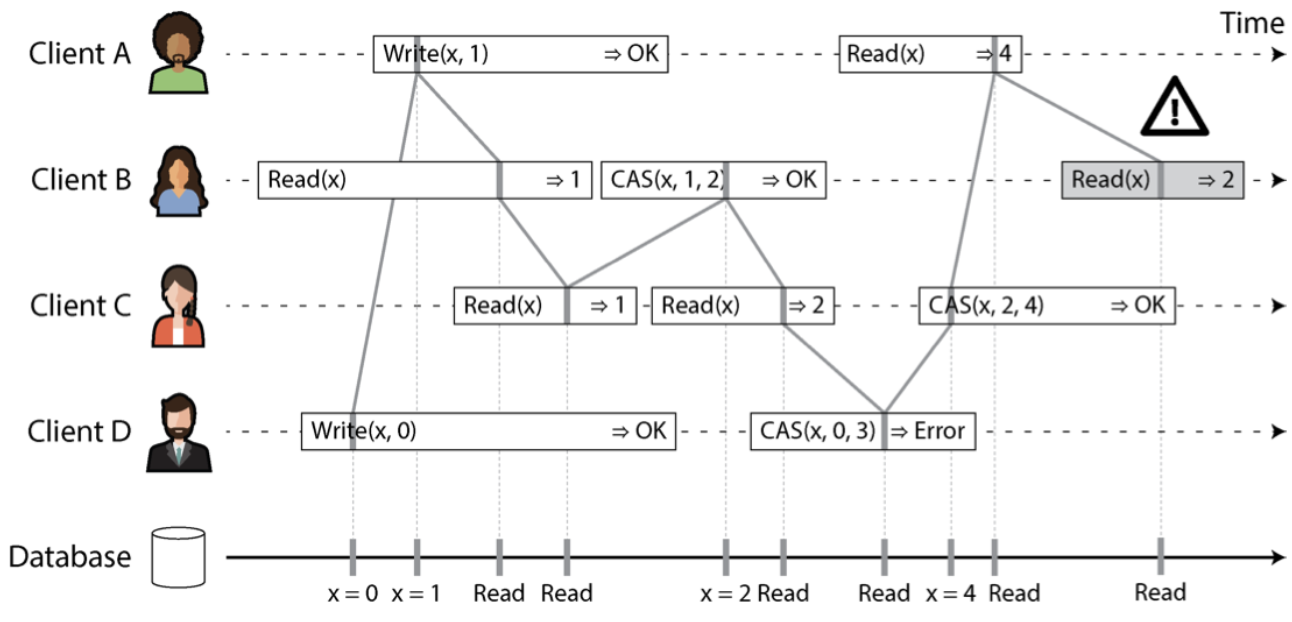
Linearizable 系统的适用场景一般都是对数据状态的一致性有严格要求的场景,首先是 lock 和 leader 选举的场景,在一次抢锁或 leader 选举后,系统中只能有一个特定的 client 持有锁或者成为 leader ,而不能有多个(也即读的结果不稳定)。然后是有要求某些条件,比如唯一性,必须满足且固定,比如说在生成 unique id 的场景,类似于是抢 unique id 的值对应的锁,一次只能绑定一个特定的特定的 client 。最后是 cross-channel timing dependencies ,书中举的例子为,A 系统将数据写入至 B 后,通知 C 去读 B,如果不是 linearizability,就会导致 C 读不到 B 的数据,或者读到的是老数据。
为了实现 Linearizable 的系统,可以使用如下的策略,首先是 single-leader replication ,在这种机制下,如果只允许 leader 处理读写操作,follower 不允许处理读请求,那么从外部来看,和单节点是一样的,所以是 Linearizable 的。需要注意的是,这有一个前提是不能出现脑裂的情况,也即不能同时存在两个 leader 。对于 consensus algorithms 也是一样的,需要保证访问的是 leader ,且当前不存在多个 leader 。对于 multi-leader replication ,由于已经预设了系统中存在多个 leader ,目标为最终一致性,所以必然无法满足 Linearizable 。
由于需要保证系统的强一致性,就会导致系统的整体性能变差,不适合高吞吐低时延的场景。即使是多核 CPU 也不保证一个核的数据变更实时同步到其他核(除非使用 memory barrier 或者 fence)
ID generator
对于一个分布式系统,如何为其中的数据/操作生成唯一 ID 是一个挺有意思的问题。如果是希望生成的 ID 是顺序的,也即可以反映出操作的先后顺序,一种方式就是部署一个独立的单实例的 id 生成服务,就做两件事情:1)生成 id 并自增。2)保存当前 id 信息至磁盘。对于写磁盘,可以通过预先往磁盘上记录一个范围的 id 来避免在生成 id 时实时写磁盘。
如果希望 ID 随机就行的话,一种方式也是部署一个专门用于生成 id 的服务,每一个实例负责生成一个分片的 id ,例如奇数和偶数,另一种方式是基于 uuid 或时间戳来生成,其中基于时间戳的场景,需要再带上一些额外的信息,例如机器的 ip 等,来保证唯一,MongoDB 的 ObjectID 就是这么搞的。之前有一次一个业务往 MongoDB 里写了大量的数据,但是由于其中没有写入时间戳的字段,就导致无法基于时间来清理历史数据。我得知这部分数据只写入不更新后,就让业务基于预期过期的时间 mock ObjectID ,如果存量数据的 ObjectID 小于这个 mock ObjectID ,就代表是写入时间早于过期时间的数据,可以进行删除操作。
Consensus
上面提到的 Linearizability 的一些场景,不论是抢锁、选 leader 还是数据一致性,其实都是一个系统中的节点达成了某种共识,比如说 client A 抢到了锁、client B 是当前的 leader 、key C 当前的 value 是 c 。Paxos、Raft、Zab 就是让节点达成共识的算法。
一般来说,共识算法都会使用 shared logs ,也即各个成员中都会维护一个 logs 来记录所有对于数据的写操作。如果各个成员之间的 logs 都是一致的,那么对应的数据状态预期也是一致的。当发生 leader 切换了,会要求新的 leader 必须持有老 leader 的 logs 。在一些场景下,为了可以让 leader 可以尽快选出以恢复服务,允许 logs 不那么新的成员成为 leader ,例如 Kafka 的 unclean leader election ,这样设置虽然可以缩短 leader 选举的时间,但是由于新 leader 的 logs 不全,会导致部分数据丢失。在进行 leader 选举的时候会进行投票,除了这种场景外,在 leader append logs 的时候,也会要求有半数成员投票通过,才可以被认为 append logs 成功。为了防止出现多个 leader 的情况,一般也会引入 epoch ,如果同时存在两个 leader ,那么 epoch 大的 leader 就是当前有效的 leader 。每次进行 leader 选举时,epoch 都会增大。
通常参与投票的成员列表都是写死的,比如说 zk 的 zk_servers 和 Kafka 的 controller.quorum.voters 都是写死在配置文件中的,MongoDB shard 集群的成员列表信息是维护在 rs.conf() 里的。将服务上云后,在实例自动迁移时如何更新成员的信息是一个比较麻烦的问题。 对于 zk 来说,目前是不允许实例迁移(如果机器需要维修,那么对应的实例就暂时下线),MongoDB 则是在实例迁移后在启动脚本中动态更新 rs.conf() 的配置。对于 Kafka 来说,也是在新实例启动时动态获取列表并更新 controller.quorum.voters ,不过跟 MongoDB 不同的是,为了可以让存量实例也能感知到 voter 的变更,对其的源码进行了修改,让其可以感知到 logs 中的 voter 变更(详见博文《kafka raft 模式下普通 broker 无法自动更新 voter 列表问题修复》)。
针对网络不稳定导致频繁触发选主的问题,有一个优化叫做 “pre-vote” 。比如 A、B、C 组成一个集群,A <-> B 和 A <-> C 的网络是通的,但是 B <-> C 之间的网络不稳定。某一时刻 B 是 Leader ,由于 C 跟 B 通信不畅,就发起了 Leader 选举,由于 C 和 A 的通信是通畅的,所以 A 投票给了 C ,C 成为了 Leader 。之后 B 给 C 发 Append 请求,发现 C 已经成为了新的 Leader 。此时情况反过来了,由于 C 跟 B 通信不畅,所以 B 发起了 Leader 选举,由于 B 和 A 的通信是通畅的,所以此时 B 又成了 Leader ,如此反复。引入了 “pre-vote” 后,一开始 C 会问 A 是否会投票给它,但是由于 A 和 B 的网络是通畅的,所以 A 会拒绝,因此整体继续保持 B 为 Leader 。
基于共识算法实现的系统,比较典型的有 ZooKeeper 和 Etcd ,它们提供的能力有:
- Locks and leases - Kafka 的 controller 节点类似于是一个锁,抢到这个节点的 broker 会成为 controller
- Support for fencing - zk 的 zxid
- Failure detection - Kafka 实例启动时会在 zk 上注册 broker id
- Change notification - Kafka 的 ISR 变更、删 topic 等操作也会注册在 zk 上,由 controller 订阅
通常使用 Consensus 的场景一般都是写吞吐每那么高,但是对一致性强要求的业务,一般是用于存储系统重要的配置和状态